【實測】單卡 RTX 5080 挑戰 125B 大模型:Strata 運行 Qwen 3.8 Flash Next 三次請求與監控紀錄
在等待第二張 RTX 5080 到貨的這幾天,手上的單卡 5080 當然不能閒著。
我在本地工作站部署 Strata,運行 Qwen3.8-Flash-Next,並透過 WebUI Monitor 觀察請求速度與硬體狀態。這篇整理的是當次監控畫面中的三筆請求,不是多輪重複測試後的標準效能排名。
當次測試配置
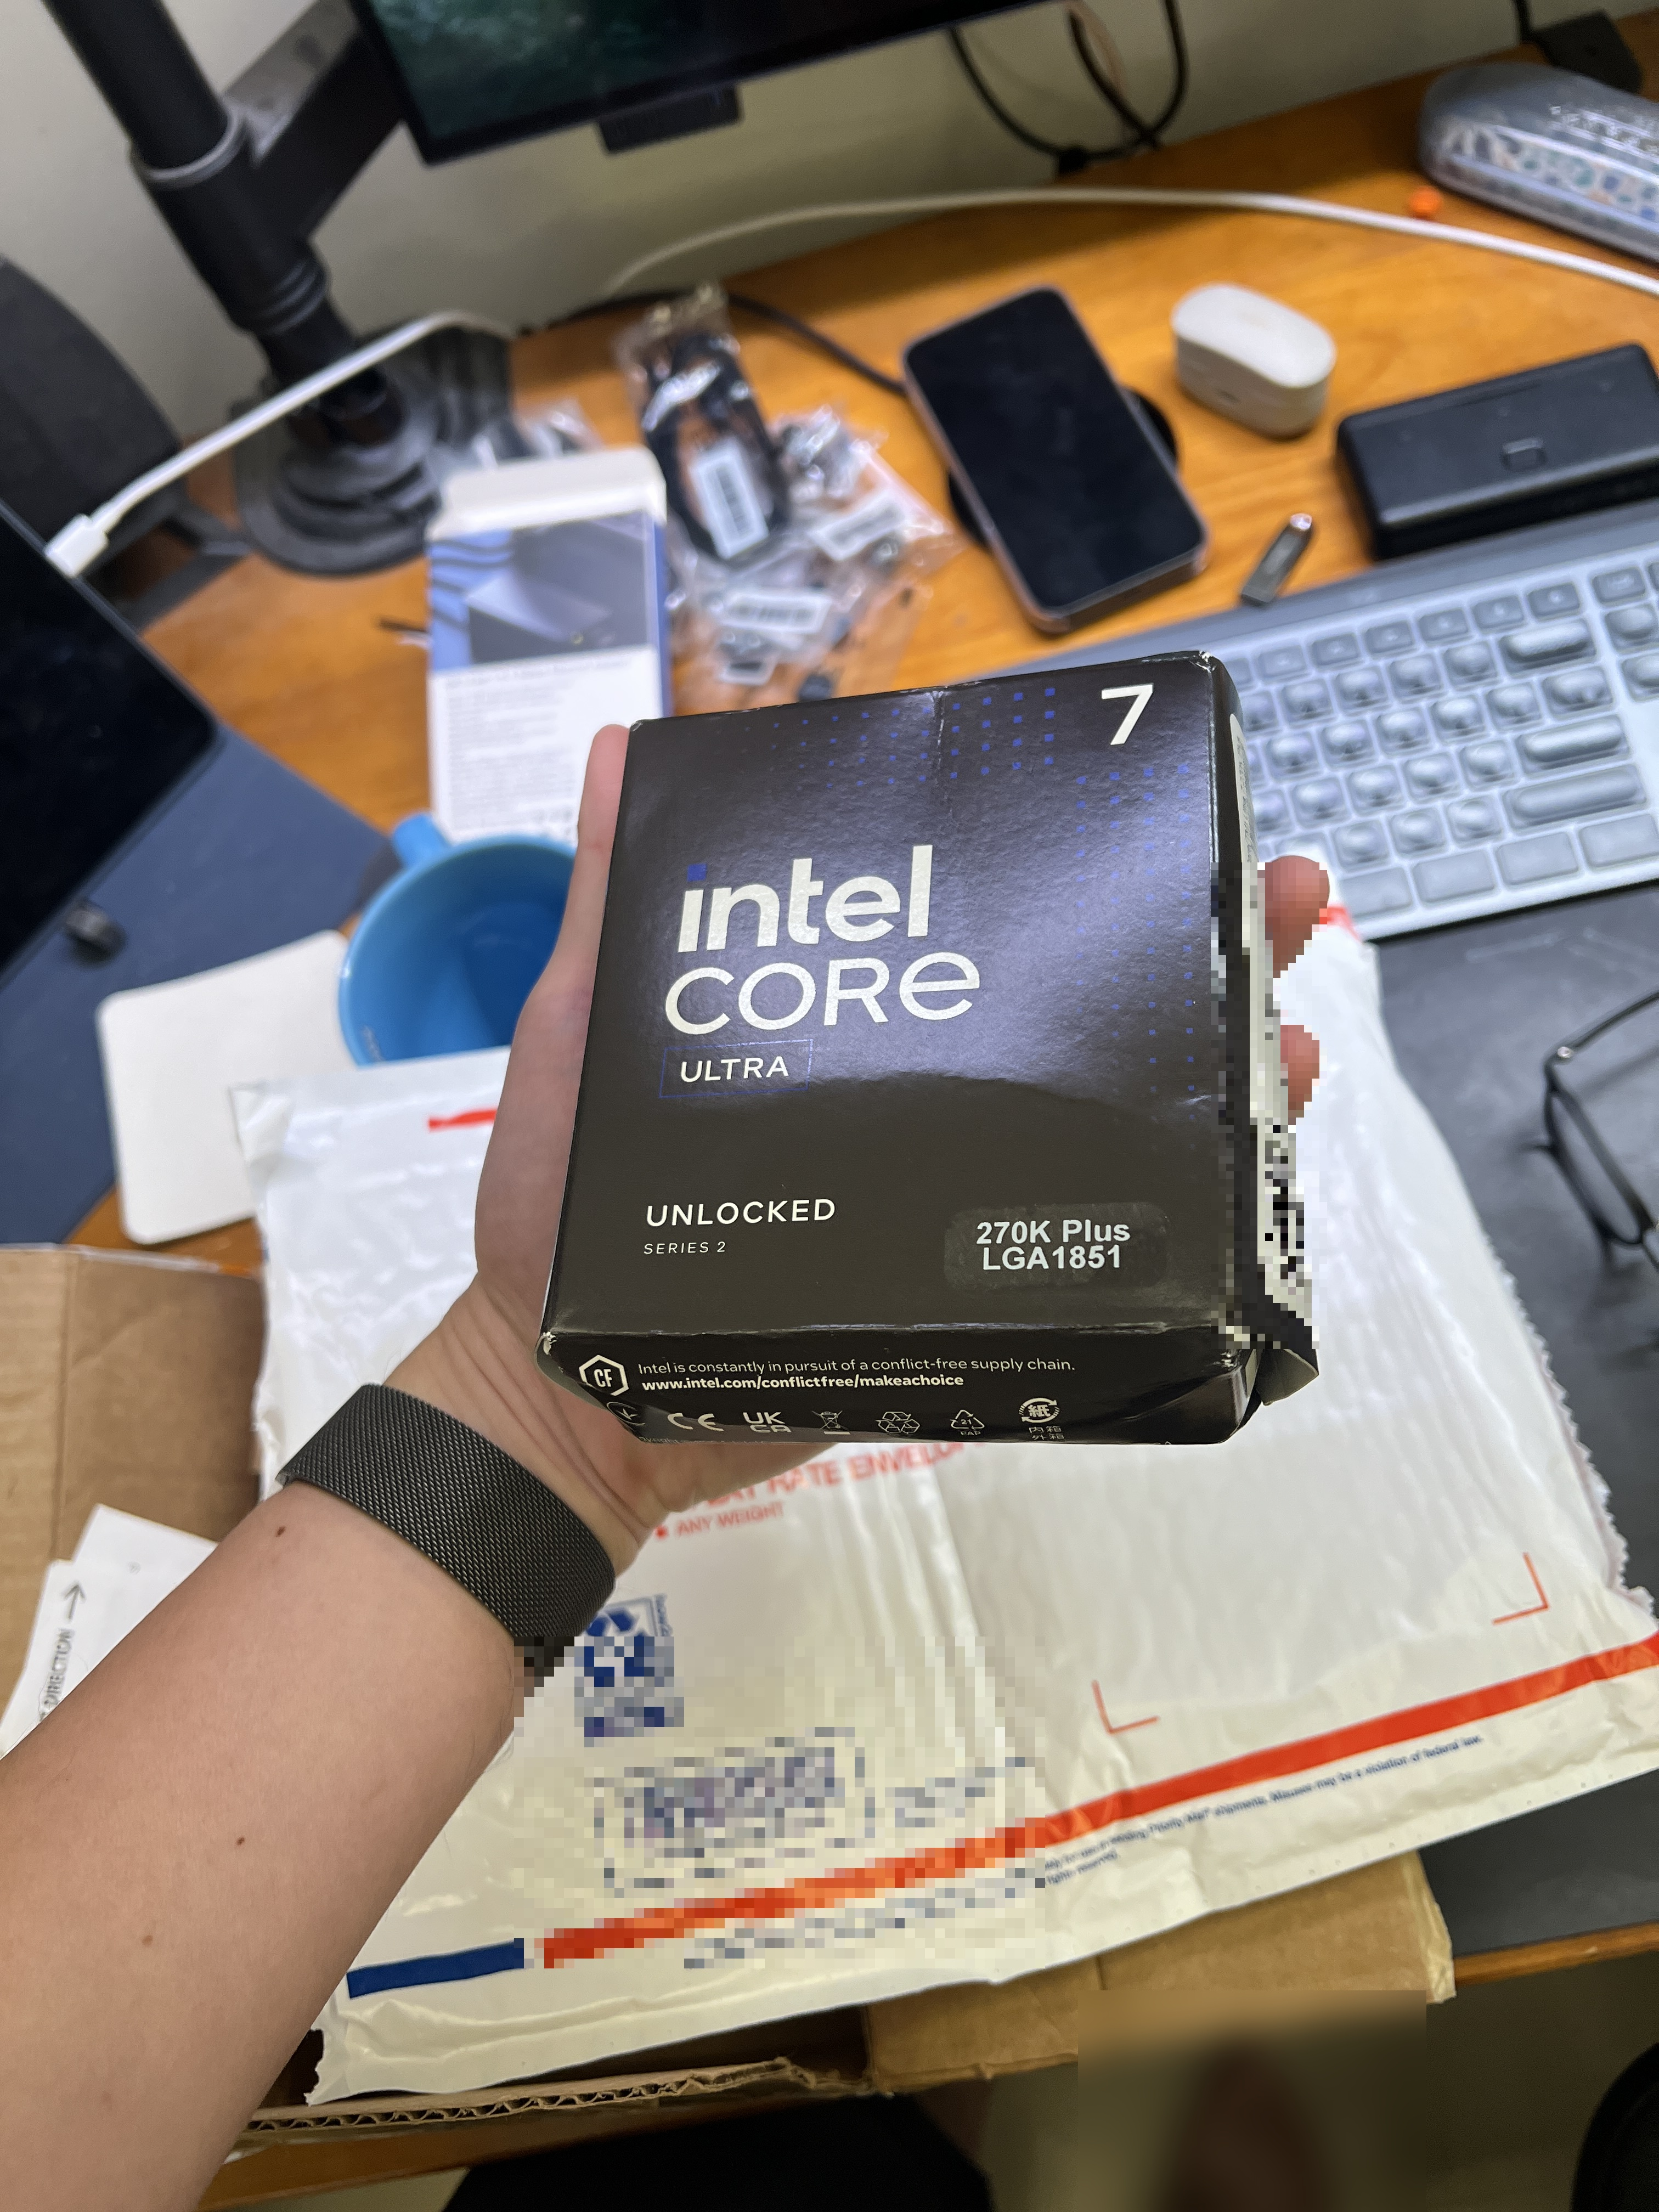
- CPU:Intel Core Ultra 7 270K Plus,24 核/24 執行緒,官方最高 Turbo 5.5GHz;並非全核心持續 5.5GHz。
- GPU:技嘉 RTX 5080 WINDFORCE OC SFF 16G,16GB GDDR7。依官方 30Gbps、256-bit 計算,理論顯存頻寬為 960GB/s。
- RAM:使用 Crucial Pro DDR5 套件;截圖顯示系統 RAM 約 83.5/95GB,代表當次環境約 96GB 等級,不能當成 192GB 配置的測試。
- 軟體:當時部署紀錄為 Strata v0.1.39、模型名稱
qwen3.8-flash-next-iq3_s。截圖本身未顯示版本與完整啟動參數。 - 上下文設定:監控顯示 256K 上限,當次最長 Prompt 為 148,984 tokens。這是引擎設定與監控值,不等於已驗證全部上下文範圍的回答品質。
- 連線:區域網路連至本地工作站服務。
硬體規格來源:Intel 270K Plus、技嘉顯卡規格。
16GB 顯存如何搭配大模型?
Strata 專案將 Qwen3.8-Flash-Next 描述為 125B 模型,並提供利用系統 RAM 與 GPU 的執行方式;模型文件也列出不同量化版本的記憶體需求。能執行不代表全部權重都放在 16GB 顯存裡。
僅按 125B 參數 × 4 bits 計算,權重本身就約 62.5GB(十進位),尚未計入量化中繼資料、KV Cache 與其他緩衝。MoE 每個 token 只啟用部分專家,也不表示其餘權重不用儲存。
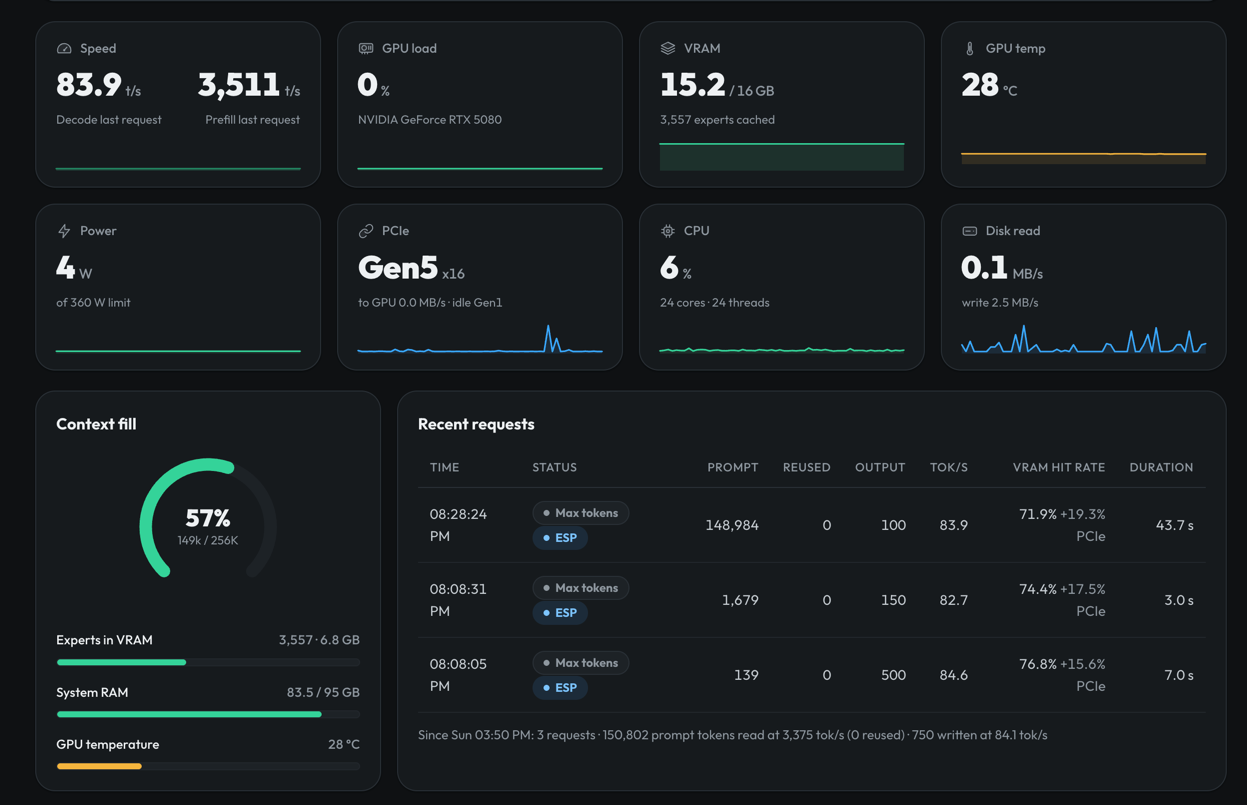
截圖顯示 3,557 個專家快取、約 6.8GB 的 Experts in VRAM,以及約 83.5GB 的系統 RAM 使用量。這些是監控欄位的回報,不能直接推導完整的權重配置或所有專家的搬運路徑。
三筆請求的可核對數據
以下數字直接取自截圖中的 Recent requests。原紀錄沒有附完整 Prompt/回答,因此以請求序號呈現,不再自行指定「代碼分析」「技術文件理解」等場景。
| 指標 | 請求一 | 請求二 | 請求三 |
|---|---|---|---|
| Prompt tokens | 139 | 1,679 | 148,984 |
| Reused tokens | 0 | 0 | 0 |
| Output tokens | 500 | 150 | 100 |
| Decode(TOK/S) | 84.6 | 82.7 | 83.9 |
| VRAM hit rate | 76.8% | 74.4% | 71.9% |
| 同欄 PCIe 標示比例 | 15.6% | 17.5% | 19.3% |
| Duration | 7.0s | 3.0s | 43.7s |
| 結束狀態 | Max tokens | Max tokens | Max tokens |
頁面彙總為 3 筆請求、150,802 個輸入 tokens、750 個輸出 tokens,並顯示輸出加權速度約 84.1 tok/s;輸入與輸出總數可由上表加總核對。最後一筆的 Prefill 約為 3,511 tok/s,Context fill 約 57%(149K/256K)。
這裡的 Decode 是輸出階段速度,不包含等待第一個 token 的全部時間。請求三的總耗時是 43.7 秒,不能只看到 83.9 tok/s 就說長 Context「零延遲懲罰」。三筆請求的輸出長度也不同,尚不足以證明所有長度都不會影響效能。
VRAM hit rate 與 PCIe 比例依監控欄位原樣記錄;兩者不是「顯存使用率」與「總線使用率」,不能由百分比換算 PCIe 的 GB/s,也不能把其餘全部視為同一種 RAM 命中來源。畫面上的 ESP 標籤不含建議/接受 token 數,因此不在此列出投機解碼接受率。
至於超長 Context 的答案是否找對關鍵字,必須有題目、答案與評分紀錄才能檢驗。這張效能截圖不能證明 100% 檢索正確率。
截圖當下的硬體狀態
| 欄位 | 畫面顯示 | 能說明的範圍 |
|---|---|---|
| GPU load | 0% | 截圖瞬間的負載,並非推論全程 |
| GPU power | 約 4W,limit 360W | 截圖瞬間功耗與軟體設定上限 |
| GPU temperature | 28°C | 截圖瞬間 GPU 溫度 |
| VRAM | 約 15.2/16GB | 畫面四捨五入後的使用量 |
| Experts in VRAM | 3,557、約 6.8GB | 監控回報的專家快取 |
| PCIe | Gen5 x16;即時 to GPU 為 0.0MB/s | 連線資訊與當下傳輸值,未保留全程峰值 |
| CPU | 約 6% | 截圖瞬間的使用率 |
| System RAM | 約 83.5/95GB | 當次環境的回報值 |
畫面有歷史曲線,但沒有可讀的峰值刻度或匯出的時間序列,因此不能據此填入 181W、41°C、38.8GB/s 等全程峰值。也沒有牆端電表或噪音量測,這次先不延伸成整機能耗與靜音評測。
使用感受與下一步
這三筆請求顯示單卡 5080 在當時配置下可以完成短輸入與約 149K tokens 的長輸入,Decode 都落在約 83~85 tok/s。我主觀覺得生成過程流暢;token 不等於中文字,不能直接拿這個數字比較人的閱讀速度或不同雲端 API。
第二張 5080 到貨後,我會再確認 Strata 版本支援的多卡方式,以相同模型、Prompt、輸出長度與功耗設定比較。兩張 16GB 卡的容量合計 32GB,但不會自動變成單一 32GB 顯存池;也不能先保證命中率達 95%、輸出超過 120 tok/s 或效能翻倍。
先把這次確實留在畫面上的數據記錄好,再逐步補上可重現的測試,是我接下來想做的事。